ТЕМА 2 ТИПОЛОГИЯ БАЗ ДАННЫХ
Ядром любой базы является модель данных, которая представляет совокупность правил формирования структур данных и операций по их обработке: ввода, изменения, поиска, вывода. В зависимости от способа организации данных в БД различают четыре основных типа их моделей: иерархическую, сетевую и реляционную (табличную), объектно-ориентированную.
2.1 Иерархическая модель БД
Иерархическая модель наиболее полно отвечает потребностям проектирования баз знаний и построена на ряде принципов (тема 1), одним из которых является принцип иерархического дерева. Первая область этого дерева – это дерево типов данных, вторая – дерево самих данных. Дерево типов описывает структуру данных дерева данных, поэтому без него нет никакой логической целостности дерева данных. Для начала рассмотрим пример с телевизионной камерой. Отраженный свет попадает в объектив камеры, там он разлагается на три составляющие: красный, синий и зеленый. Записывая уровни освещенности трех составляющих света 25 раз в секунду, можно составить представление об освещенности и отражающей способности предметов, которые снимаются на камеру.
Иерархическая база данных представляет совокупность элементов, связанных между собой определенными правилами. Объекты, связанные иерархическими отношениями, образуют ориентированный граф (перевернутое дерево), корень которого находится вверху (рисунок 2.1). Основными определениями понятий по иерархической модели базы являются: уровень, элемент (узел), связь.
Уровень – это определённая ступень в БД, на которой все данные обладают одинаковыми свойствами. Самый верхний уровень (нулевой) в иерархическом дереве имеет только одну вершину (корень дерева), которая не подчиняется никакой другой вершине. Количество деревьев в БД определяется числом корневых записей. Кроме корня, в иерархической базе существуют другие вершины, называемые узлами.
Под узлом понимают совокупность атрибутов данных, описывающих некоторый объект. На схеме иерархического дерева они представляются вершинами графа. Зависимые (подчиненные) узлы располагаются ниже нулевого уровня – на первом, втором, третьем и т.д. Каждый узел на более низком уровне связан только с одним узлом, находящимся на более высоком уровне. От корневой записи к каждой записи БД на нижних уровнях существует только один (иерархический) путь. Например, на рисунке 2.1 для записи В4 путь к корню БД будет проходить через запись Б2 к А.
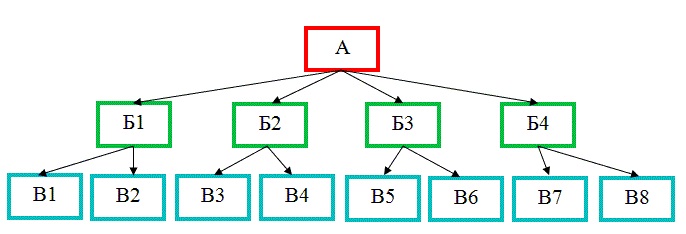
Рисунок 2.1 – Графическое изображение иерархической структуры БД
Уровень упрощения описания объекта – это уровень детализации представления об объекте реального мира, достаточный для его описания и последующего использования. В предыдущем примере о телевизионной камере представление об объекте дается помощью совокупностей его освещенности. Можно было бы дать огромное количество других характеристик этого объекта, вплоть до химического состава и геометрии кристаллов, но этого делать не нужно, так как, чтобы показать фильм на экране, достаточно знать изменение уровня освещенности снятого объекта. Значит, для создания полного представления об объекте и использования на практике представлений о нем достаточно упростить объект реального мира до совокупности уровней его освещенности.
Свойство объекта – одна из характеристик объекта реального мира, информацию о котором необходимо хранить в базе данных. Например, в рассмотренном примере у объекта имеется три свойства – это уровни составляющих отраженного света: красный, синий и зеленый.
События, отраженные в БД, – набор реакций объекта на изменения внешних условий, описанных в БД; например, зная интенсивность падающего света на объект и интенсивность отраженного света от объекта, можно описать реакцию объекта на изменение освещенности через коэффициент отражения.
Тип БД – набор свойств и событий объекта, описанных как единый комплекс. При этом в зависимости от уровня упрощений свойства объекта могут изменяться. Например, совокупность трех событий (трех цветов) дает конкретный тип объекта – снимаемый на камеру предмет.
Объект описания в БД – совокупность типов и свойств объекта, объединенных в один тип, способный описать его как объект реального мира. В рассмотренном примере один тип достаточен для описания объекта, снимаемого на камеру; но бывают случаи, когда для составленииия простой модели одного типа недостаточно. Например, объект «машина» состоит из более мелких элементов: кузова, рамы, мотора, колес и т.д. Эти элементы, в свою очередь, тоже являются объектами, которые сами состоят из других элементов, имеющих еще меньшие размеры; например, для колеса – это обод, камера, покрышка и т.д.; а камера, в свою очередь, состоит из оболочки, ниппеля, давления воздуха и т.д. Можно бесконечно углубляться в детализацию элементов машины, но, как правило, этого не требуется, так как человек, собравший колесо, рассматривает его уже как цельный объект, а не состоящий из отдельных элементов. Колесо передается на главный конвейер, где оно уже рассматривается как элемент, входящий в состав более крупного объекта – рамы, включающей и другие элементы. На следующей стадии сборки нет необходимости удерживать в поле зрения пользователя БД такой элемент машины, как колесо, потому, что пользователя интересует уже рама, к которой прикреплено не только это колесо, но и другие части машины. Далее рама рассматривается как элемент, входящий как свойство в объект машина. Человек, пришедший покупать машину, рассматривает ее как объект в целом. Из этих рассуждений видно, что концептуальная модель очень гибка и самодостаточна для описания внешнего мира и позволяет двигаться от простого к сложному, описывая все, что входит в технологический процесс.
Связь данных в БД – это свойство элемента, характеризующее взаимосвязь между элементами данных в дереве данных или способ изменения значения свойств объектного типа соответственно. Различают три типа связей: включение в дерево данных, вставка из другого типа значения свойств элементов данных и ссылка на экземпляр типа в дереве данных. Включение данных позволяет строить дерево данных. Например, если объектом является офис, который состоит из свойств объектного типа – комнат, то описать любой офис прямо в его типе нельзя, т.к. заранее неизвестно, сколько будет комнат и какого типа, поэтому необходимо описывать связь типа «офис» с типом «комната». Создав экземпляр данных типа «офис», можно добавить к этому узлу дерева данных нужное количество ветвей типа «комната».
Рассмотрим другой пример: накладная состоит из оглавления и списка товаров. При этом можно рассматривать заглавие как узел дерева данных, а список товаров, как ветви дерева данных, исходящие из этого узла.
Использование ссылки в базе данных характеризуется тем, что, будучи установленной один раз, она не разрывается после редактирования. Это похоже на вычисляемое свойство таблицы базы данных. Если изменить тип данных, на который установлена ссылка, то во всех экземплярах типов, где есть ссылка на этот тип будет произведено изменение.
2.2 Сетевая модель базы данных
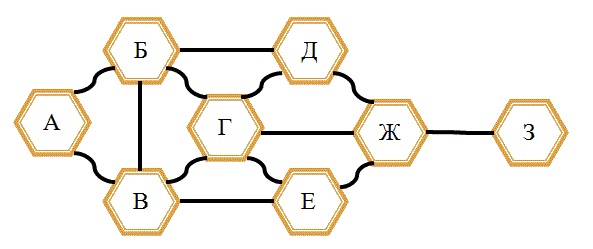
Сетевая БД отличается от иерархической базы данных наличием свободных связей между вершинами разных уровней (рисунок 2.2).
Вершина может иметь множество подчиненных вершин, и существует множество вершин, которым она подчинена. Для описания схемы сетевой БД используется две группы типов: «запись» и «связь». Тип «связь» определяется для двух видов «записи»: предка и потомка. Предком или родителем называются данные, из которых получаются новые данные. Потомком называются данные, получаемые в результате обработки исходных данных (родителей). Переменные типа «связь» являются экземплярами связей. Таким образом, сетевая БД состоит из набора записей предок-потомок и набора соответствующих связей. На формирование связи особых ограничений не накладывается.
Если в иерархических структурах запись-потомок имеет только одну запись-предка, то в сетевой модели данных запись-потомок может иметь произвольное число записей-предков (сводных родителей). В качестве примера можно привести БД структурную схему построения кафедры (рисунок 2.3).
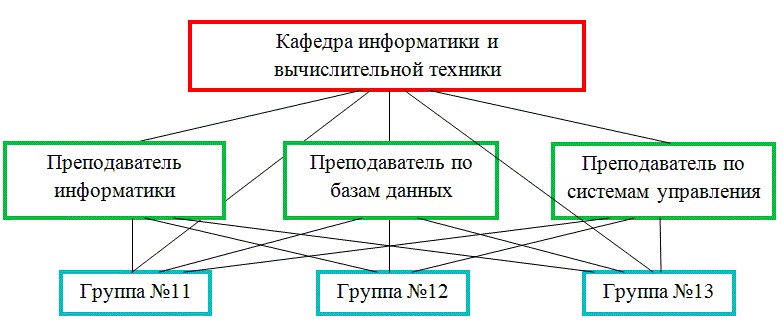
Рисунок 2.3 – Сетевая база данных «Кафедра»
Из этой схемы видно, что одной и той же группе студентов могут преподавать разные дисциплины несколько преподавателей. В то же время один преподаватель может работать в нескольких группах. Непосредственно за уровнем преподавания дисциплин ведет контроль соответствующая кафедра.
В различных СУБД сетевого типа для обозначения одинаковых по сути понятий зачастую используются различные термины. Например, такие как элементы и агрегаты данных, записи, наборы, области и т.д.
Физическое размещение данных в базах сетевого типа может быть организовано практически теми же методами, что и в иерархических БД.
К числу важнейших операций манипулирования данными баз сетевого типа можно отнести следующие: 1) поиск записи БД; 2) переход от предка к первому потомку; 3) переход от потомка к предку; 4) создание новой записи; 5)удаление текущей записи; 6) обновление текущей записи; 7) включение записи в связь; 8) исключение записи из связи; 9) изменение связей между записями и т.д.
Достоинством сетевой модели данных является возможность эффективной реализации по показателям затрат памяти и оперативности. В сравнении с иерархической моделью сетевая модель представляет большие возможности в смысле допустимости образования произвольных связей.
Недостатком сетевой модели данных является высокая сложность и жесткость схемы БД, построенной на ее основе, а также сложность для понимания и выполнения обработки информации в БД обычным пользователям. Кроме того, в сетевой модели данных ослаблен контроль целостности связей вследствие допустимости установления произвольных связей между записями.
Система на основе сетевой модели не получила широкого распространения на практике. Наиболее известными сетевыми СУБД являются: IDMS, db_Vitsll, СЕТЬ, СЕТОР, КОМПАС.
2.3 Реляционная база данных
Основоположником теории реляционных баз данных считается сотрудник фирмы IBM доктор Э.Ф. Кодд, опубликовавший 6 июня 1970 г. статью A Relational Model of Data for Large-Shared Data Banks (Реляционная модель данных длябольших коллективных банков данных). В этой статье впервые был использован термин «реляционная модель данных». Теория реляционных баз данных, разработанная в 70-х годах в США доктором Э.Ф. Коддом, имеет под собой мощную математическую основу, описывающую правила эффективной организации данных. Разработанная Е.Ф. Коддом теоретическая база стала основой для разработки теории проектирования баз данных.
Э.Ф. Кодд, будучи математиком, по образованию, предложил использовать для обработки данных аппарат теории множеств (объединение, пересечение, разность, декартово произведение). Каждая из этих операций имеет свои специфические особенности, поэтому остановимся на них несколько подробнее.
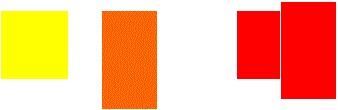
«Объединением двух совместных отношений R1 и R2 (рисунок 2.4) одинаковой размерности (R1 UNION R2) является отношение, содержащее все элементы исходных отношений (с исключением повторений)» .
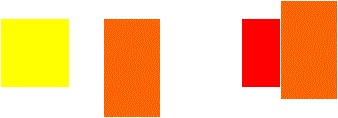
«Вычитание (разность) совместимых отношений R1 и R2 (рисунок 2.5) одинаковой размерности (R1 MINUS R2) есть отношение, тело которого состоит из множества кортежей, принадлежащих R1, но не принадлежащих отношению R2» [1, с. 67]. Результат операции вычитания зависит от порядка следования операндов, то есть R1 MINUS R2 и R2 MINUS R1 – не одно и то же.
R1 R2 R={R1 UNION R2}
R1 R2 R={R1 MINUS R2}
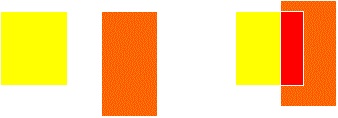
«Пересечение двух совместных отношений R1 и R2 (рисунок 2.6) одинаковой размерности (R1 INTERSECT R2) порождает отношение R с телом, включающим в себя кортежи, одновременно принадлежащие обоим исходным отношениям».
R1 R2 R={R1 INTERSECT R2}
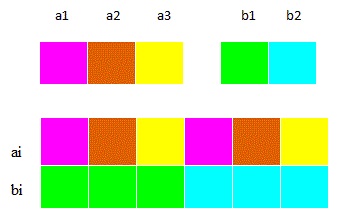
«Произведение (декартовое) отношения R1 степени к1 и отношения R2 степени к2 (R1 TIMES R2), не имеющие одинаковых имен атрибутов, есть такое отношение R степени (к1+к2), заголовок которого представляет сцепление заголовков отношений R1 и R2, а тело имеет кортежи такие, что первые к1 элементов кортежей принадлежат множеству R1, а последние к2 элементов – множеству R2». Пример 1: если даны два множества A (a1,a2,a3) и B (b1,b2), их декартово произведение будет иметь вид С=A*B (a1*b1, a2*b1, a3*b1, a1*b2, a2*b2, a3*b2.
Отношение: Отношением R, определенным на множествах {D1, D2, …Dn} называется подмножество декартова произведения {D1*D2*…*Dn}. При этом: множества {D1, D2, …Dn} называются доменами отношения; элементы декартова произведения d1*d2*…dn называются кортежами; число n определяет степень отношения (n=1 - унарное, n=2 - бинарное, ..., n-арное); количество кортежей называется мощностью отношения.
Пример: на множестве С=A*B (смотри пример выше) могут быть определены отношения R1 (a1*b1, a3*b2) или R2 (a1*b1, a2*b1, a1*b2)
R= {R1 TIMES R2}
Наименьшая единица реляционной базы данных – это отдельное атомарное (неразложимое) для данной модели базы значение данных. Так, в одной предметной области фамилия, имя и отчество могут рассматриваться как три различных значения (таблица 2.1) или как единое значение (таблица 2.2).
В БД ключевым полем является поле, в таблице 2.1 – код преподавателя, а в таблице 2.2 - соответствующее номеру личного дела, так как они однозначно определяют запись, содержащую сведения о каждом преподавателе или студенте группы. В качестве ключевого поля можно выбрать поле – ФИО преподавателя или студента, но в пределах учебного заведения вполне могут оказаться преподаватели или студенты, у которых полностью совпадут (хотя и маловероятно) фамилия, имя и отчество, поэтому первый вариант выбора более предпочтительный. Реляционная модель данных обычно состоит из нескольких таблиц, которые связываются между собой по ключевому полю – полю, однозначно определяющему соответствующую запись. Ключ (ключевое поле) называется простым, если он однозначно определяет соответствующую запись в базе данных, или составным, если записи однозначно определяются значениями нескольких полей. Каждое значение ключевого поля в пределах одной таблицы должно быть уникальным, то есть его имя не должно повторяться в других записях.
Таблица 2.1 – Реляционная база данных «Преподаватели» с раздельными полями ФИО
Код Пр. |
Фами-лия |
Имя |
Отчест-во |
Дата рож-дения |
Долж-ность |
Дисцип-лина |
Служеб-ный телефон |
Дом. телефон |
Зар-плата |
1 |
Иванов |
Иван |
Ивано-вич |
05.01. |
Доцент |
Инфор-матика |
54-55-54 |
53-53-53 |
1000,00р. |
2 |
Петров |
Петр |
Петро-вич |
12.02. |
Профес-сор |
Матема-тика |
23-23-23 |
25-25-25 |
1500,00р. |
3 |
Сидо-ров |
Павел |
Юрье-вич |
25.07. |
Доцент |
Эконо-мика |
67-66-50 |
68-69-70 |
1200,00р. |
4 |
Гришин |
Олег |
Сергее-вич |
14.02. |
Ассис-тент |
Матема-тика |
65-64-62 |
67-02-35 |
800,00р. |
5 |
Мохов |
Максим |
Викто-рович |
15.03. |
Доцент |
Эконо-мика |
64-56-01 |
56-02-35 |
1100,00р. |
Таблица 2.2 – Реляционная база данных студенты с ФИО в едином поле
Номер личного дела |
ФИО студента |
Пол |
Дата рождения |
Группа |
50234 |
Иванов И.И. |
Муж. |
12.09.1989 |
Эо-21 |
50235 |
Петров П.П. |
Муж |
12.05.1987 |
Эо-21 |
50236 |
Сидоров С.С. |
Муж |
01.10.1986 |
Эо-22 |
50237 |
Краснова Е.К. |
Жен. |
06.08.1985 |
Эо-22 |
Любая таблица в реляционной базе данных, так же как и в электронных таблицах Microsoft Excel состоит из строк и столбцов. Однако под элементарной единицей в MS Excel понимается ячейка, которая образуется на пересечении строки и столбца, а в MS Access – совокупность ячеек, расположенных в одной строке.
Строки таблицы в реляционной базе данных соответствуют кортежам, а столбцы – полям. Каждый кортеж представляет собой описание одного объекта реального мира (в данном случае преподавателя). Параметры, которые содержатся в столбцах или полях, называют характеристиками или атрибутами этого объекта (в таблице 1 для каждого преподавателя – это будут ФИО, дата рождения, должность, дисциплина, номер телефона, зарплата).
Реляционная модель представляет свои отношения в виде двумерных таблиц. Каждая таблица представляет собой двумерный массив и содержит фиксированный набор столбцов, соответствующих атрибутам, доменам или полям и переменный набор строк, соответствующих кортежам или записям. Любая таблица в реляционной БД обладает следующими свойствами:
-
каждый элемент таблицы – это один элемент данных;
-
каждое поле реляционной базы данных должно иметь уникальное (неповторяющееся) имя, тип поля, и другие дополнительные характеристики, например, такие как длина, формат и т.п.
-
все поля в таблице должны быть однородными, т.е. все данные, содержащиеся в одном поле, должны иметь один и тот же тип, длину и т.п.
-
в таблице не должно быть одинаковых строк, т.е. с полностью одинаковыми полями;
-
порядок следования строк и столбцов может быть произвольным.
Реляционная модель базы данных обладает следующими достоинствами:
- 1) простотой структуры представления данных
- 2) удобным для пользователя заполнением исходными данными табличных форм
- 3) возможностью использования формального аппарата алгебры отношений и реляционного исчисления для обработки данных, простота, понятность и удобство физической реализации на персональном компьютере
- 4) более удобными, чем в других моделях, поисковыми системами
- 5) наглядные системы сортировки данных.
К недостаткам можно отнести: отсутствие стандартных средств идентификации отдельных записей и сложность описания иерархических и сетевых связей.
2.4 БД на основе объектно-ориентированного подхода
При разработке БД на основе объектно-ориентированного подхода используются три принципа описания реального объекта в базе данных. Первый принцип – это инкапсуляция, которая подразумевает разделение интерфейсной части описания объекта и его реализации. Интерфейсная часть позволяет с одной стороны, освободить пользователя от не принципиальных для него механизмов разработки описания конкретных свойств реального объекта, а с другой вооружить его эффективными и простыми механизмами работы с базами данных. Под реализацией понимается программирование всех механизмов обработки данных, описанных в интерфейсе. Таким образом, под инкапсуляцией понимается способность изменять реализацию любого класса объектов без опасения, что это вызовет нежелательные побочные последствия в программной среде.
Наследование - это воспроизведение в последующих данных свойств и методов, использованных в предыдущих данных. При этом в новых данных должны присутствовать и новые индивидуальные признаки. Эти признаки могут быть определены либо добавлением к описанию, либо изменением свойств и методов преобразования самих данных. Наследование – это действие с интерфейсной частью, но никак не с самими данными, т.е. не может граф с данными содержать в себе наследование, например, не может строка в накладной наследоваться свойствами от ее верхней части. Понятие наследование можно трактовать еще следующим образом: «Наследование – это возможность создавать из имеющихся классов новые классы по принципу «от общего к частному». Наследование можно представить как способ описания дерева типов, например как тип литературы, от которого наследуются типы других данных: книг, журналов, статей и т.д. При этом поддерживается полиморфизм.
Полиморфизм - это способность ядра базы данных корректно работать с последующими записями, зная описания предыдущих. Например, если необходимо напечатать накладную, платежное поручение или чертеж для которых используется один и тот же принтер, то будут вызваны методы печати, которые напечатают именно то, что должно быть, а не метод печати этих данных, тем более, что он в данном случае абстрактный. Другими словами под полиморфизмом понимается способность объектов выбирать метод обработки на основе типов данных, принимаемых в сообщении. Аналогичный пример полиморфизма можно дать из литературы, если есть свойство автор, то, произведя поиск по его фамилии и инициалам, можно найти все книги, журналы и статьи этого автора.
Традиционные базы данных (в том числе и реляционные и некоторые объектные) построены вокруг центрального сервера, выполняющего все операции над базой. А в объектно-ориентированных – используются распределенные вычисления (без трансляций между объектной и реляционной моделями). По существу, эта модель БД мало, чем отличается от мэйнфреймовой организации 60-х годов с центральной ЭВМ, в которой с помощью мэйнфрейма (mainframe), выполнялись все вычисления, а с пассивных терминалов посылались исходные данные, и на них отображался результат решения задачи.
Такая архитектура имеет ряд недостатков, главным из которых является вопрос масштабируемости. В настоящее время рабочие станции (клиенты) имеют вычислительную мощность порядка 30 – 50 % мощности сервера базы данных, то есть большая часть вычислительных ресурсов распределена среди клиентов. Поэтому все больше приложений, в первую очередь базы данных и средства принятия решений, работают в распределенных средах, в которых объекты (объектные программные компоненты) распределены по многим рабочим станциям и серверам, где любой пользователь может получить доступ к любому объекту. Благодаря стандартам межкомпонентного взаимодействия все эти фрагменты кода комбинируются друг с другом независимо от аппаратного, программного обеспечения, операционных систем, сетей, компиляторов, языков программирования, различных средств организации запросов и формирования отчетов и динамически изменяются при манипулировании объектами без потери работоспособности.
Основным достоинством БД является возможность отображения информации о сложных взаимосвязанных объектах, то есть она позволяет идентифицировать отдельную запись БД и определить функции ее обработки. Недостатками этой БД являются: высокая понятийная сложность, неудобство обработки данных и низкая скорость выполнения запросов.
Теория